Сповіщення в Telegram про високе навантаження на сервер
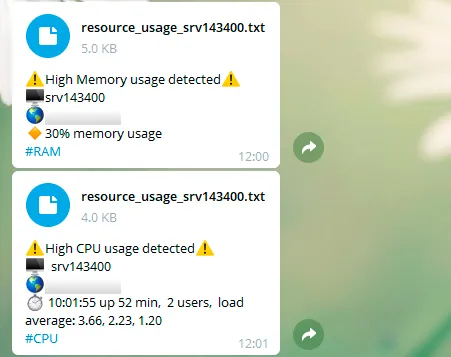
Про проблему на сервері краще дізнатися до того, як сайт перестане відкриватися. Для одного-двох серверів розгортати повноцінну систему моніторингу необов’язково: вистачить невеликого скрипта, який раз на кілька хвилин перевіряє навантаження й пише в Telegram, якщо воно перевищило поріг.
Що будемо відстежувати
- Load average — середня кількість процесів, що очікують процесор або диск. Значення зручно порівнювати з кількістю ядер: навантаження 4 на чотириядерному сервері означає повне завантаження.
- Пам’ять — частку зайнятої оперативної пам’яті.
- Диск — заповненість кореневого розділу. Переповнений диск зупиняє бази даних і пошту.
Крок 1. Створіть бота
- Відкрийте в Telegram діалог із @BotFather і надішліть
/newbot. - Задайте ім’я та логін бота, збережіть отриманий токен.
- Надішліть своєму боту будь-яке повідомлення.
- Дізнайтеся ідентифікатор чату:
curl -s "https://api.telegram.org/bot<ТОКЕН>/getUpdates"У відповіді знайдіть фрагмент "chat":{"id":123456789.
Якщо бота вже створено для сповіщень про вхід по SSH, використовуйте його ж.
Крок 2. Створіть скрипт
sudo nano /usr/local/bin/load-alert.sh#!/bin/bash
# Сповіщення в Telegram про високе навантаження, брак пам'яті та місця на диску.
TOKEN="123456789:AAH..."
CHAT_ID="123456789"
LOAD_PER_CORE=1.5 # поріг навантаження на одне ядро
MEM_LIMIT=90 # поріг зайнятої пам'яті, %
DISK_LIMIT=90 # поріг заповнення диска, %
REPEAT_AFTER=3600 # не повторювати повідомлення частіше, ніж раз на N секунд
STATE=/var/tmp/load-alert.state
CORES=$(nproc)
LOAD=$(cut -d' ' -f1 /proc/loadavg)
MEM=$(free | awk '/^Mem:/ {printf "%.0f", ($2-$7)/$2*100}')
DISK=$(df --output=pcent / | tail -n 1 | tr -dc '0-9')
PROBLEMS=""
if awk -v l="$LOAD" -v c="$CORES" -v t="$LOAD_PER_CORE" 'BEGIN {exit !(l > c*t)}'; then
PROBLEMS+="Навантаження: $LOAD при $CORES ядрах"$'\n'
fi
[ "$MEM" -ge "$MEM_LIMIT" ] && PROBLEMS+="Пам'ять зайнята на $MEM%"$'\n'
[ "$DISK" -ge "$DISK_LIMIT" ] && PROBLEMS+="Диск заповнений на $DISK%"$'\n'
# усе гаразд: скидаємо стан і виходимо
if [ -z "$PROBLEMS" ]; then
rm -f "$STATE"
exit 0
fi
# не надсилаємо те саме частіше за заданий інтервал
NOW=$(date +%s)
if [ -f "$STATE" ] && [ $((NOW - $(cat "$STATE"))) -lt "$REPEAT_AFTER" ]; then
exit 0
fi
echo "$NOW" > "$STATE"
TOP=$(ps -eo pcpu,pmem,comm --sort=-pcpu | head -n 6)
TEXT="⚠️ $(hostname)
$PROBLEMS
Найактивніші процеси:
$TOP"
curl -s --max-time 10 \
--data-urlencode "chat_id=${CHAT_ID}" \
--data-urlencode "text=${TEXT}" \
"https://api.telegram.org/bot${TOKEN}/sendMessage" > /dev/nullСкрипт містить токен бота, тому закрийте до нього доступ:
sudo chown root:root /usr/local/bin/load-alert.sh
sudo chmod 700 /usr/local/bin/load-alert.sh
Крок 3. Перевірка
Запустіть скрипт вручну:
sudo /usr/local/bin/load-alert.shЯкщо навантаження в нормі, повідомлення не буде — це правильна поведінка. Щоб перевірити надсилання, тимчасово встановіть MEM_LIMIT=1 і запустіть скрипт ще раз. Не забудьте повернути значення й видалити файл стану:
sudo rm -f /var/tmp/load-alert.stateКрок 4. Запуск за розкладом
Відкрийте таблицю завдань root:
sudo crontab -eДодайте рядок — перевірка кожні п’ять хвилин:
*/5 * * * * /usr/local/bin/load-alert.shДокладніше про формат розкладу — у статті про cron.
Як підібрати пороги
- Навантаження. Значення
1.5на ядро означає, що сервер перевантажений у півтора раза. Короткочасні піки до цього рівня зазвичай нешкідливі; якщо повідомлення надходять надто часто, підніміть поріг до2. - Пам’ять. Linux використовує вільну пам’ять під кеш, тому скрипт вважає зайнятою лише ту пам’ять, яку не можна звільнити. Значення понад 90% — привід розібратися.
- Диск. 90% — розумний поріг: залишиться час звільнити місце до повної зупинки служб.
Параметр REPEAT_AFTER захищає від потоку однакових повідомлень: поки проблема зберігається, сповіщення повторюється не частіше ніж раз на годину.
Що робити, коли надійшло сповіщення
У повідомленні вже є список найактивніших процесів. Далі допоможуть:
top                 # процеси в реальному часі
free -h             # пам'ять
df -h               # місце на дисках
du -sh /var/log/*   # що займає місце в журналах
Обмеження скрипта
Скрипт працює на тому самому сервері, за яким стежить. Якщо сервер завис або втратив мережу, сповіщення не надійде. Для контролю доступності ззовні потрібен окремий сервіс — наприклад, Uptime Kuma — на іншому VPS. Коли серверів стає більше й потрібна історія метрик, переходьте на Grafana і Prometheus.
Відеоінструкція